Notícias
Ensinar uma rede neuronal a voar — sem a redesenhar para voo

UM PROJETO DA EVOLEO, DA AIRBUS DEFENCE AND SPACE E DA TUM
AI4NCA — desenvolvimento tecnológico apoiado pela ESA
Dentro do AI4NCA: como um modelo de IA para segurança marítima passou de uma GPU de portátil para uma placa de processamento representativa de voo, construída segundo as normas da indústria espacial europeia — e o que aconteceu quando lá chegou.
- TRL 4→6
- Maturidade da placa elevada ao longo do projeto, verificada como equipamento representativo de voo
- 0,60
- Exatidão média de deteção (mAP) em todo o conjunto de teste
- 5,3 FPS
- Imagens processadas por segundo, a correr na própria placa
- ~543 dias
- Tempo estimado em órbita antes de os efeitos da radiação começarem a pesar
O PROBLEMA
A maioria dos aceleradores de IA de bordo é concebida uma vez, para uma só tarefa
O AI4NCA — “AI for Non-Mission Critical On-Board Data Processing” — propôs-se responder a uma pergunta mais estreita e mais prática: pode um acelerador de hardware genérico e programável correr modelos modernos de aprendizagem profunda a bordo de um satélite, dentro das restrições de tamanho, potência e radiação de uma unidade de processamento não crítica para a missão, sem ser redesenhado para cada rede nova?
Um chip construído para uma rede específica é mais eficiente nessa tarefa. Um acelerador genérico e programável abdica de parte dessa eficiência em troca da liberdade de correr uma variedade de redes neuronais ao longo da sua vida — útil quando as necessidades de uma missão podem mudar depois do lançamento. O AI4NCA testa esse compromisso diretamente, levando dois casos de uso de IA independentes pelo mesmo percurso: comprimir uma rede neuronal convencional para caber em hardware limitado, carregá-la em silício real, e medir o que sobrevive à viagem.
DOIS CASOS DE USO, UM SÓ PERCURSO
Um modelo foi para hardware. O outro ficou em simulação — deliberadamente.
IMPLANTADO · A BORDO
Segurança marítima
Deteção, classificação e estimativa de comprimento autónomas de navios — de pesca e não pesca — a partir de imagens de radar de satélite, com um detetor YOLO modificado e comprimido para caber em hardware limitado.
- 8621 imagens de satélite
- Dados de treino
- YOLO modificado
- Rede
- A placa representativa de voo
- Corre em
- Campanha completa de ensaios em hardware
- Verificado por
SÓ EM SIMULAÇÃO
Controlo ativo de MTF
Correção de erro de frente de onda por ótica ativa, para instrumentos óticos de maior abertura, com uma EfficientNetB0 modificada a calcular a correção necessária a partir de um par de fotografias.
- 1,5 m, circular única
- Abertura
- EfficientNetB0 modificada
- Rede
- Só simulação — sem hardware
- Corre em
- 24,03 nm de erro residual médio
- Resultado
O HARDWARE
Uma placa que teve de provar que era a coisa real, e não um substituto
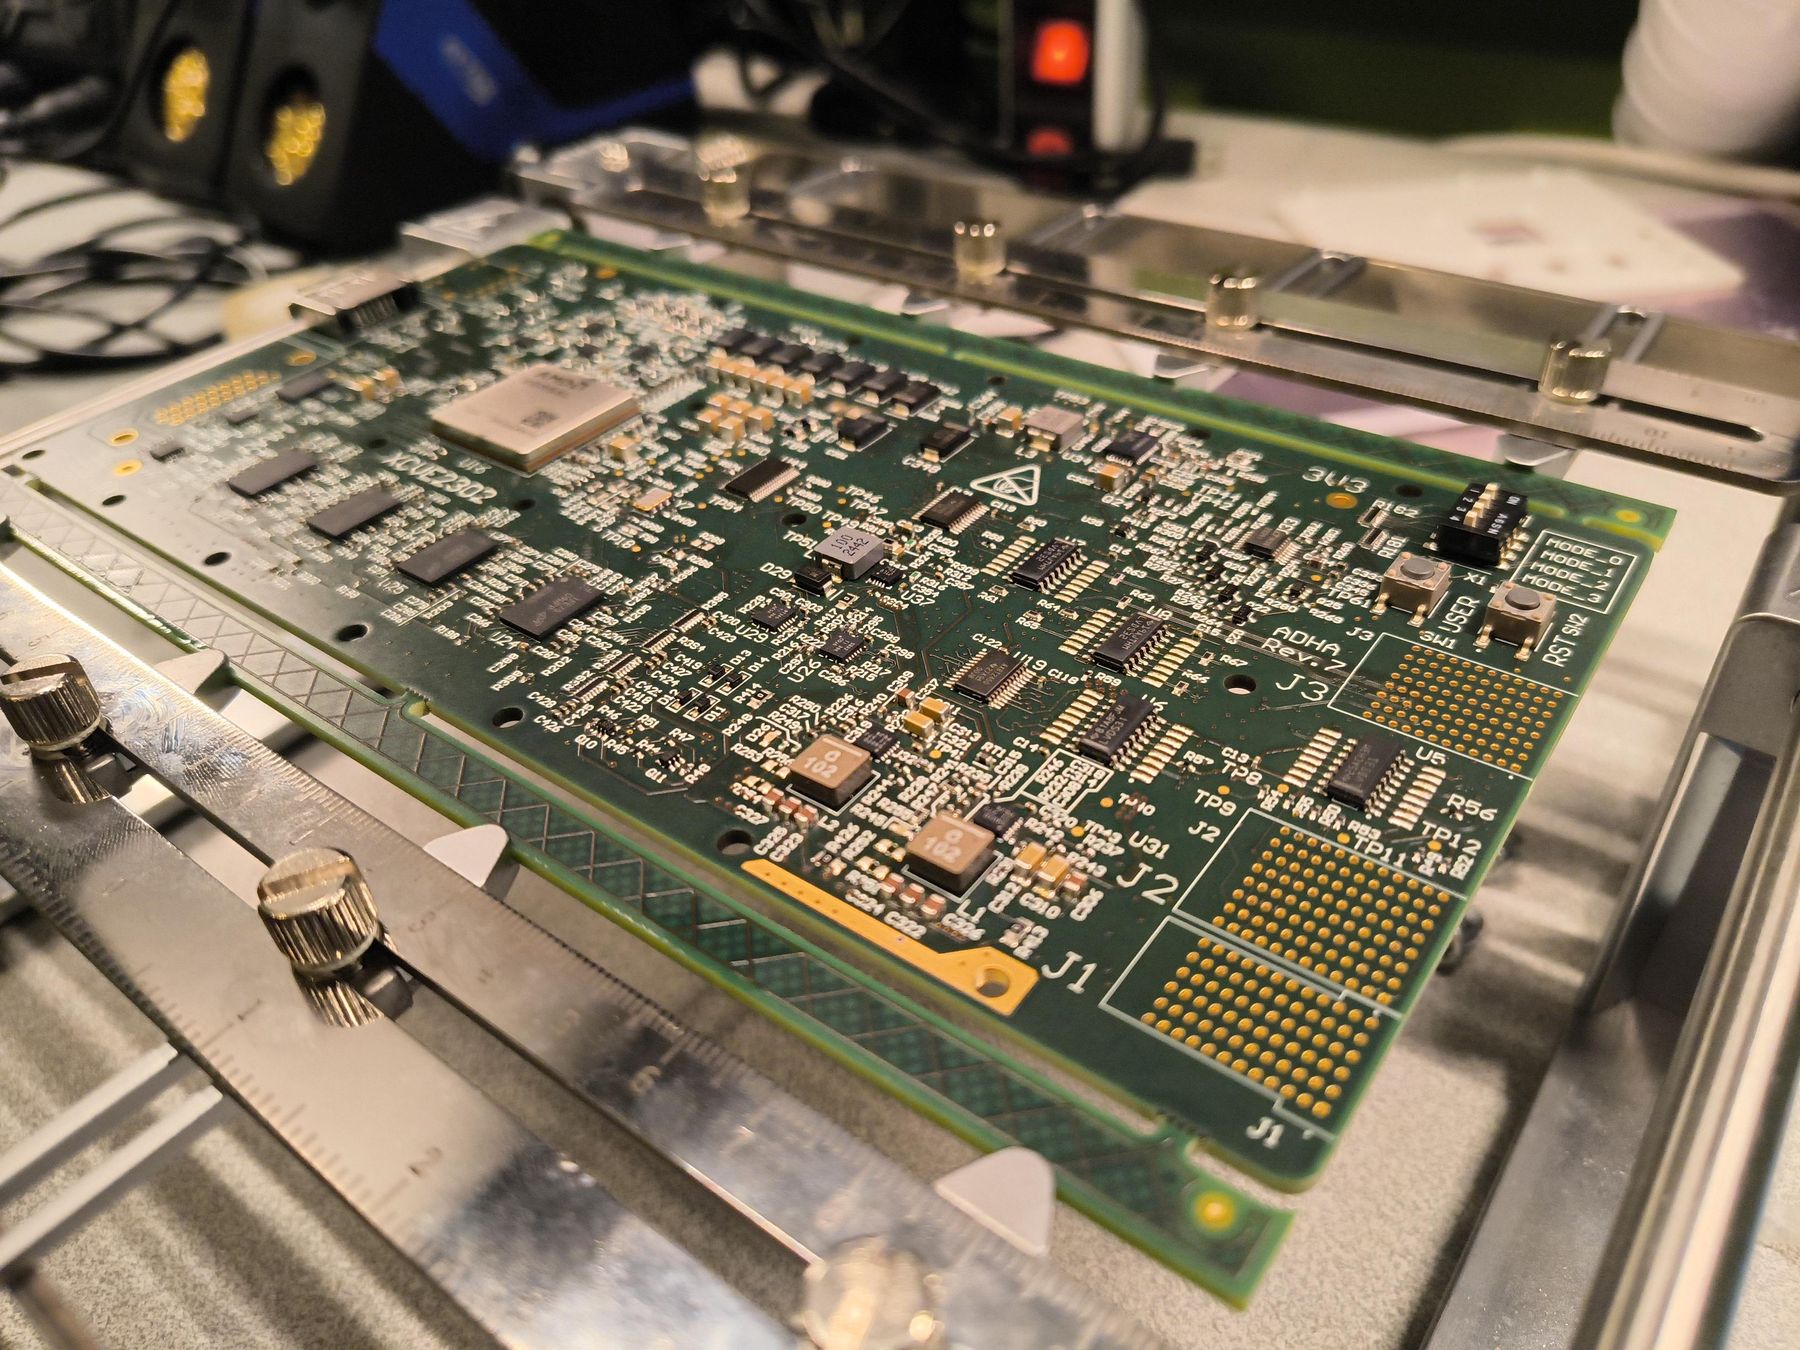
O processador no centro do AI4NCA é um chip AMD-Xilinx Versal AI Edge — e o que havia para entregar não era apenas correr código nele. A placa que leva esse chip teve de ser verificada como equivalente em forma, encaixe e função a um módulo de voo real: o mesmo tamanho, os mesmos conectores, o mesmo comportamento que um satélite veria de facto.
O CHIP
Versal AI Edge
Compatível ao nível dos pinos com uma versão de voo, tolerante à radiação, da mesma peça. Combina uma matriz de cálculo dedicada a IA com um bloco de lógica reconfigurável — o “acelerador programável” que lhe permite correr mais do que um tipo de rede neuronal.
NORMA ADHA
Construída para encaixar num barramento de satélite real
A placa foi avaliada segundo a ADHA, uma norma de arquitetura da indústria espacial europeia que cobre as dimensões do módulo, o conector de retaguarda em que ele encaixa e a forma como fala com o resto do satélite — não um protótipo só de laboratório, mas um módulo construído segundo as mesmas regras a que uma unidade de voo teria de responder.
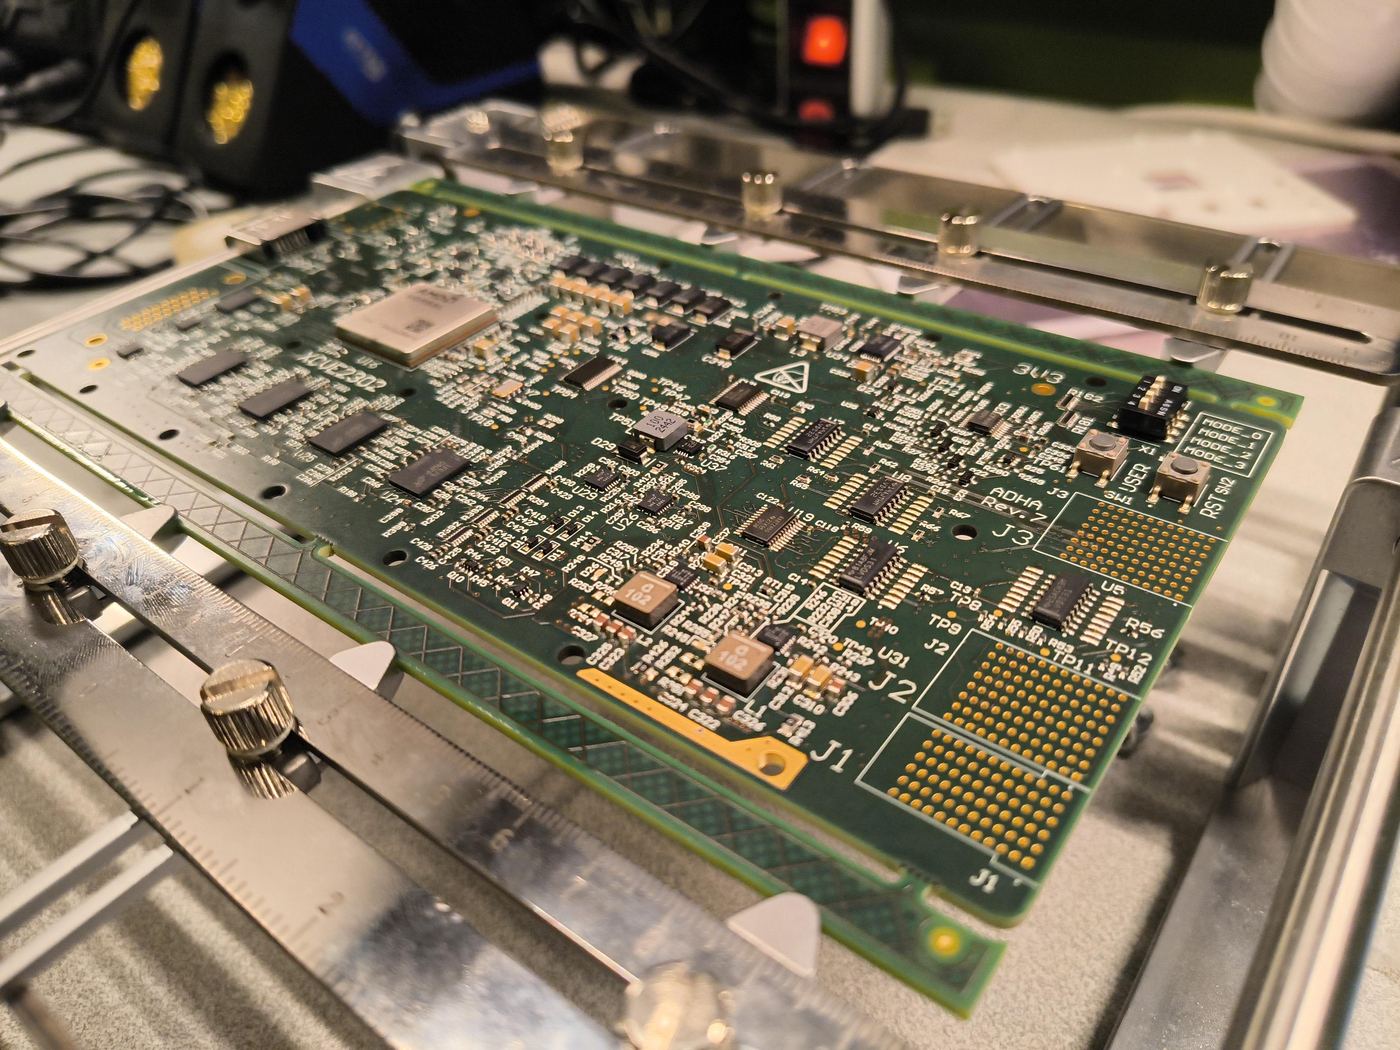
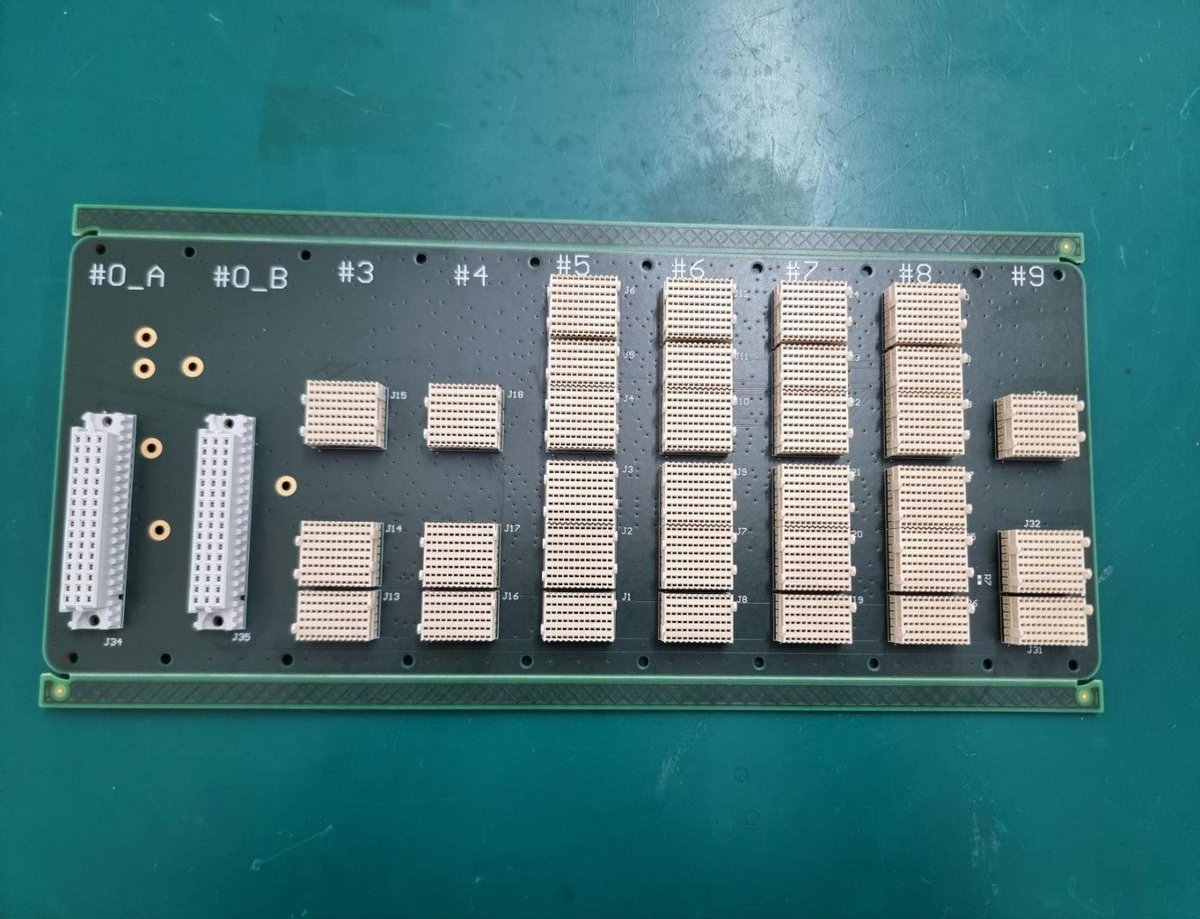
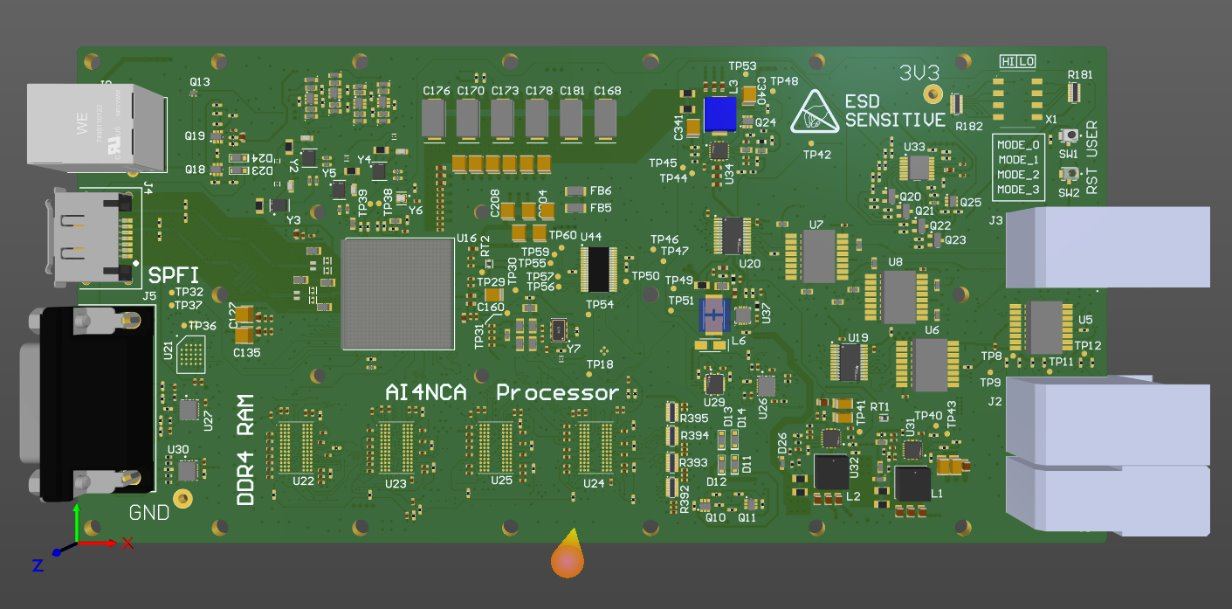
Os ensaios não se fizeram apenas na placa da própria EVOLEO. Parte da campanha correu na instalação OBPAI da ESA — uma plataforma remota de avaliação que dá a projetos aprovados acesso controlado à mesma família de chip representativo de voo, em espírito semelhante ao de um ambiente de desenvolvimento na nuvem, que dá acesso a uma máquina remota sem que essa máquina esteja em cima da secretária. É uma forma de ensaiar contra hardware representativo sem que cada equipa precise da sua própria placa física.
A CADEIA DE FERRAMENTAS
De um modelo em vírgula flutuante para algo que o chip consegue correr
As duas redes foram treinadas de forma convencional — aritmética de vírgula flutuante corrente, numa GPU comum. O caminho daí até à placa passa pela cadeia de ferramentas Vitis AI da AMD: comprime os números do modelo de vírgula flutuante para inteiros de 8 bits, e depois compila o resultado numa forma que a lógica reconfigurável do chip consegue executar diretamente.
É nesse passo de compressão que está boa parte da engenharia a sério. Passar de precisão em vírgula flutuante para inteiros de 8 bits não sai de graça — é uma perda de precisão controlada, e parte do trabalho do AI4NCA era medir exatamente quanta exatidão custou.
| Tarefa | Métrica | Antes da compressão | Depois da compressão |
|---|---|---|---|
| Deteção | Exatidão | 0,659 | 0,638 |
| Classificação (pesca) | Exatidão | 0,604 | 0,567 |
| Estimativa de comprimento | Exatidão | 0,713 | 0,709 |
Medido num conjunto reservado de 862 imagens. A exatidão perdida na compressão ficou abaixo de 5% em todas as tarefas — a margem que torna o modelo a bordo válido logo à partida, em vez de mandar imagens em bruto para serem processadas em terra.
VALIDAR O MODELO
Antes sequer de tocar em hardware de voo
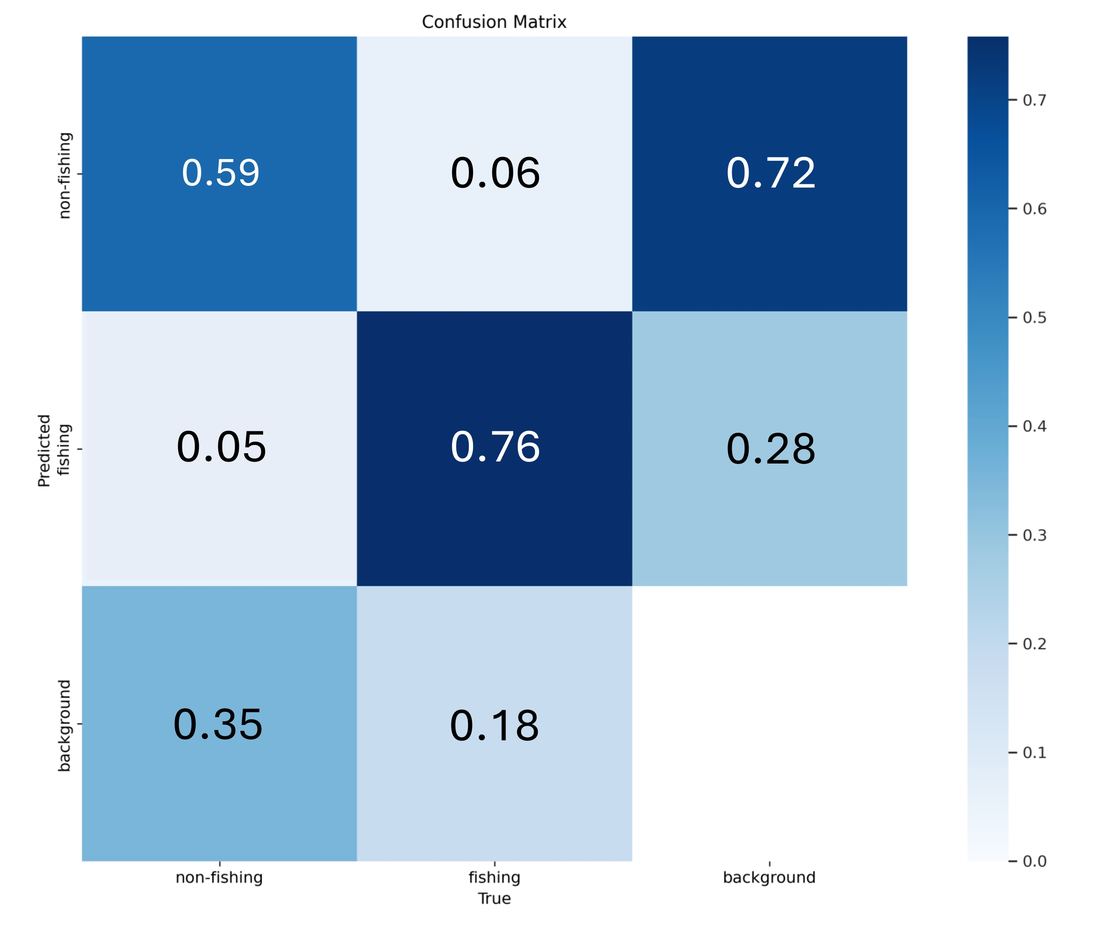
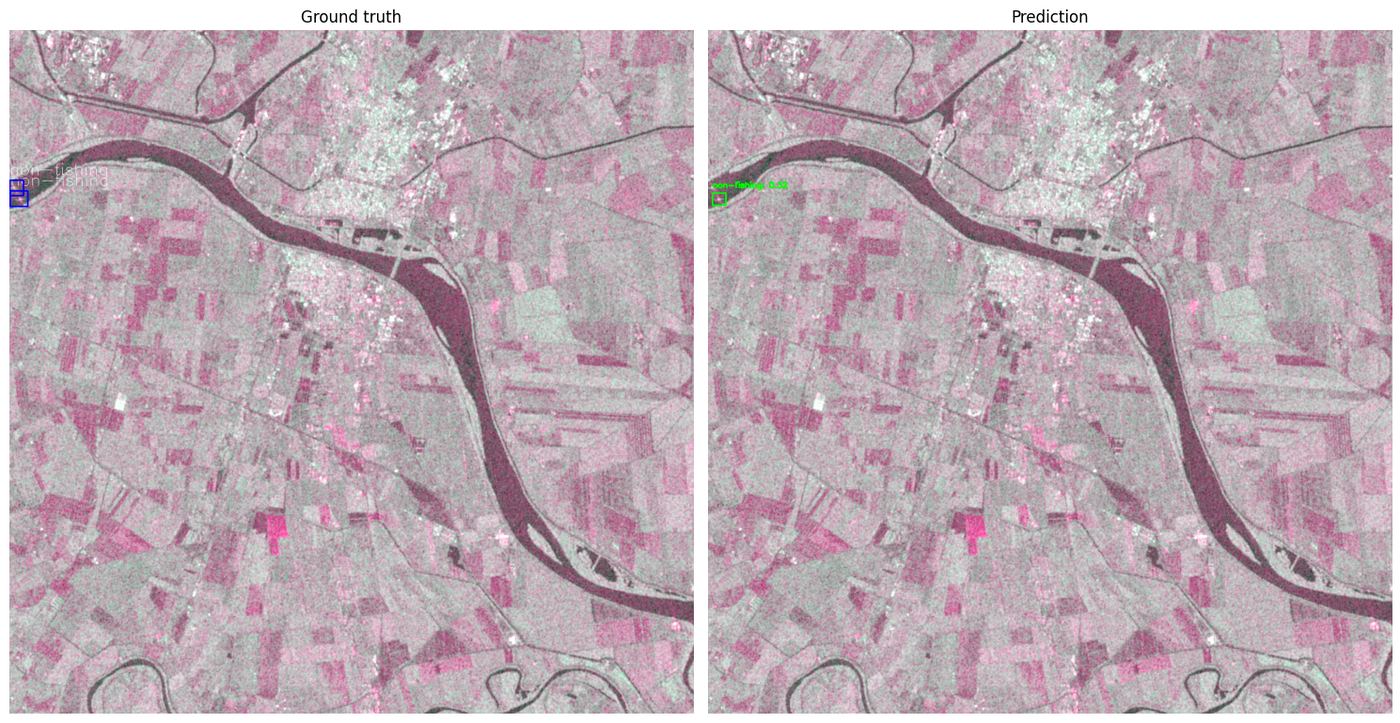
Estes dois resultados vêm de uma fase anterior do projeto — o modelo treinado avaliado num computador de desenvolvimento, contra um conjunto de teste grande, antes da compressão e antes de alguma vez ter sido carregado numa placa. Mostram que o modelo funciona; os resultados em hardware, mais abaixo, mostram que continua a funcionar depois de implantado.
A CORRER NA PLACA
O que aconteceu de facto quando o modelo ficou em hardware real
A partir daqui, todos os números foram medidos com o modelo comprimido a correr de facto na placa de processamento — não simulados, nem estimados a partir dos resultados do computador de desenvolvimento acima.
- 0,778
- Pontuação de exatidão de deteção, na placa
- 109,1 MB
- Memória que o modelo ocupa depois de carregado
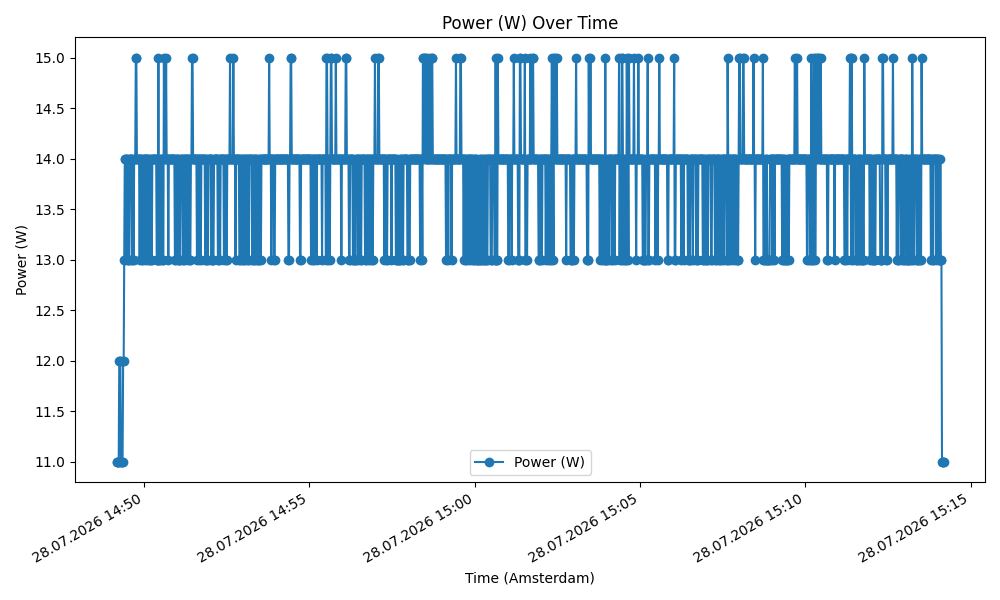
- 11–15 W
- Consumo, do repouso à inferência ativa
- 5,3–6,7 FPS
- Imagens processadas por segundo, na placa
Uma medida combinada da raridade com que o modelo falha um navio real e da raridade com que assinala algo que não é um navio. 1,0 seria perfeito nas duas contas.
Pouco o bastante para partilhar com folga a memória da placa com tudo o resto que o processador tem de fazer.
Mais ou menos o que gasta uma lâmpada doméstica forte — modesto por desenho, já que os orçamentos de energia de um satélite deixam pouca margem.
5,3 FPS corresponde a uma imagem de ponta a ponta; 6,7 FPS é o ritmo em regime permanente ao longo de 1000 execuções seguidas. De qualquer das formas, uma imagem nova fica inteiramente processada a cada quinto de segundo, aproximadamente — sem esperar por uma ligação a terra.
ROBUSTEZ À RADIAÇÃO
Simular quase ano e meio em órbita, uma inversão de bit de cada vez
A radiação cósmica em órbita inverte ocasionalmente bits individuais na memória de um chip — incluindo os números que compõem um modelo treinado. Sem proteção, um número suficiente destas “inversões por evento único” acaba por corromper a exatidão de um modelo. Para descobrir quantas são “suficientes”, a equipa corrompeu deliberadamente números crescentes de bits no modelo implantado e voltou a medir a exatidão depois de cada passo, comparando depois isso com a frequência com que tais inversões são de facto esperadas em órbita.
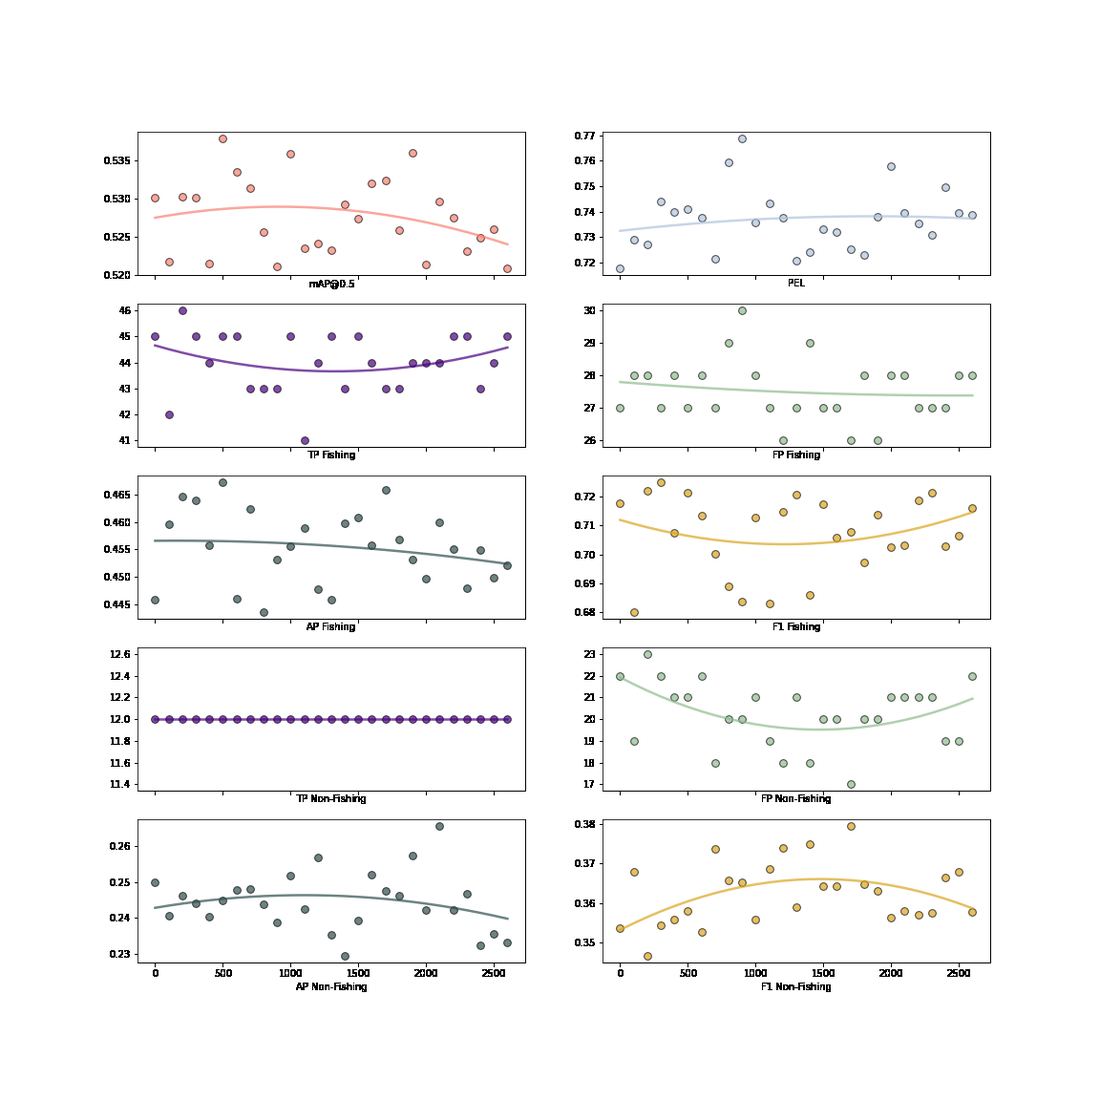
Uma rede neuronal treinada tem muita redundância incorporada — a mesma sobreparametrização que a torna mais fácil de treinar faz também com que consiga absorver um certo número de valores corrompidos antes de a saída sofrer de forma visível. Ao ritmo a que se espera que as inversões por radiação ocorram de facto em órbita, essa redundância chegou para cobrir cerca de 543 dias — cerca de ano e meio — antes de qualquer perda de exatidão mensurável, sem nenhum endurecimento adicional à radiação incorporado no software.
SEGUNDO CASO DE USO — SÓ SIMULADO
Ler um erro de frente de onda a partir de duas fotografias de aspeto vulgar
O controlo ativo de MTF recebe um tipo de entrada diferente: duas imagens da mesma cena, uma focada e outra deliberadamente desfocada. A diferença entre elas codifica exatamente a forma como a lente ou o espelho de um sistema ótico está a distorcer a imagem — e uma EfficientNetB0 modificada foi treinada para ler essa diferença de volta, sob a forma de uma correção.
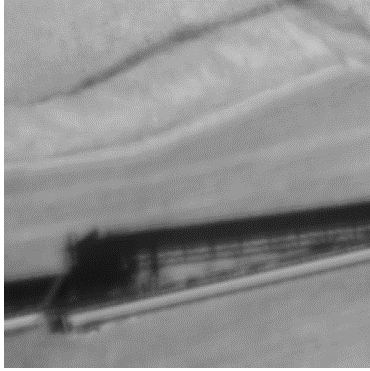
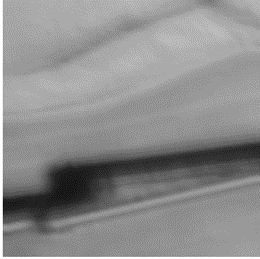
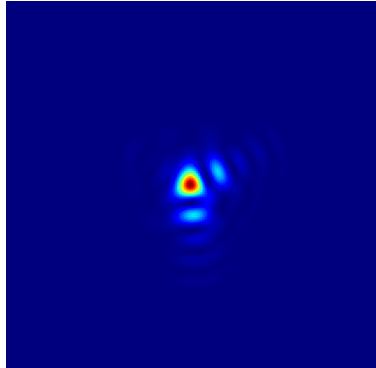
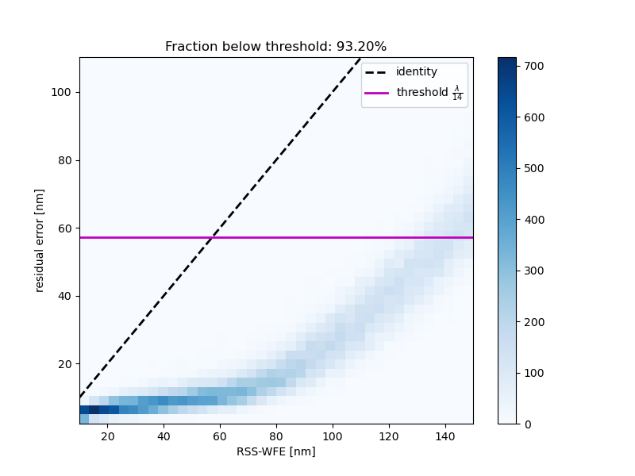
Em média, a correção deixou um erro pequeno o bastante para ficar perto do limite teórico daquilo que a própria ótica conseguiria resolver — comparável ao amaciamento que se obteria do ruído normal do sensor. Não existia bancada ótica física onde ensaiar isto, pelo que todo o ciclo de correção — câmara, distorção e correção — foi reconstruído e corrido inteiramente em simulação. Nunca foi implantado em hardware real, e o projeto trata-o em conformidade: uma ideia validada, não uma ideia voada.
PARA ONDE ISTO VAI A SEGUIR
De um fluxo de trabalho validado para um fluxo qualificado e capaz de voar
Os dois casos de uso têm agora uma resposta funcional a “isto consegue correr em hardware não crítico para a missão?” — um provado em silício real, outro provado em simulação. Os passos seguintes são levar o fluxo de trabalho da segurança marítima por uma qualificação formal de voo, e trabalhar no sentido de o demonstrar em órbita.